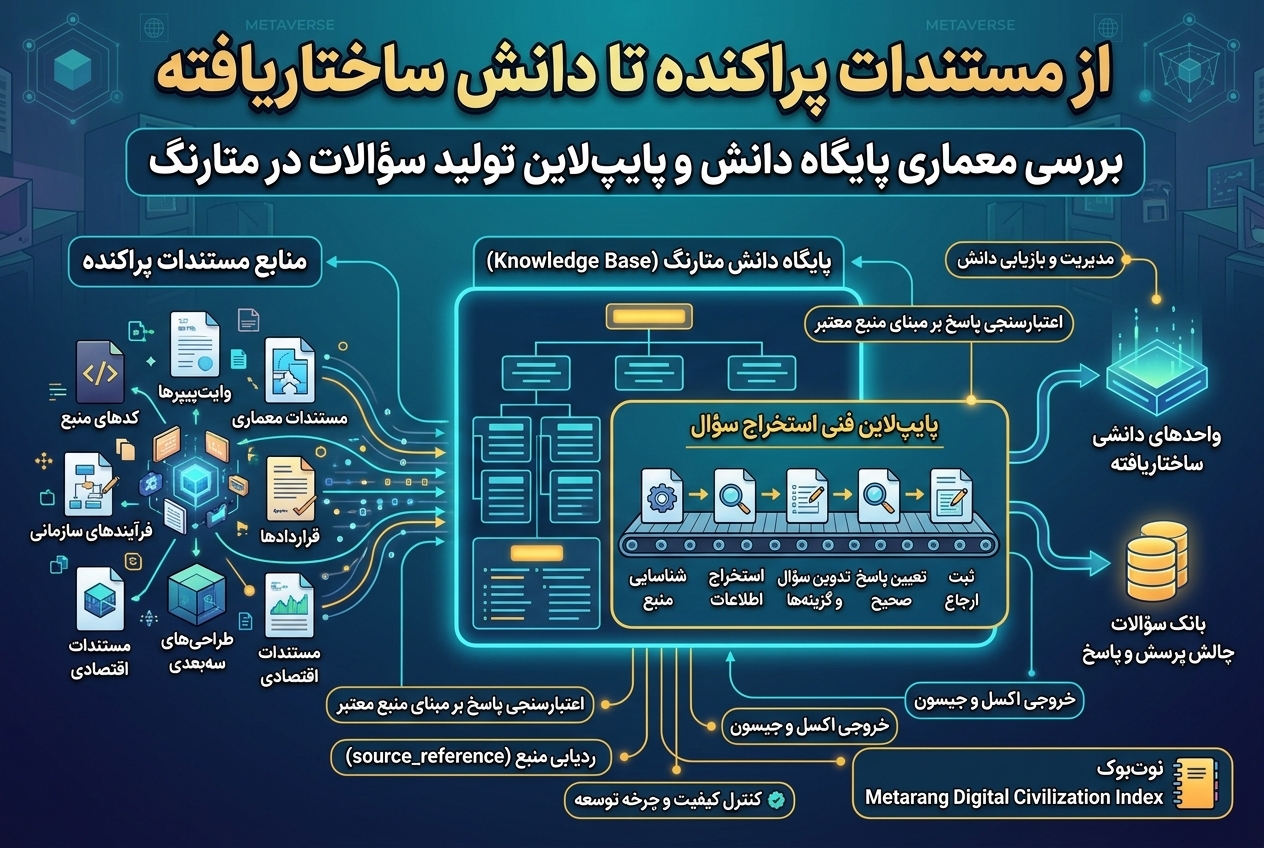
از مستندات پراکنده تا دانش ساختاریافته؛ بررسی معماری پایگاه دانش و پایپلاین تولید سؤالات در متارنگ
از مستندات پراکنده تا دانش ساختاریافته؛ بررسی معماری پایگاه دانش و پایپلاین تولید سؤالات در متارنگ
۱. چکیده
افزایش حجم مستندات فنی، نرمافزاری، اقتصادی و سازمانی در سامانههای دیجیتال، مسئله مدیریت و بازیابی دانش را به یکی از چالشهای مهم معماری سیستمهای اطلاعاتی تبدیل میکند. اطلاعات زمانی قابلیت استفاده مجدد و ارزیابی نظاممند پیدا میکنند که از منابع اولیه استخراج شده، در قالبی استاندارد سازماندهی شوند و ارتباط آنها با منشأ اصلی حفظ شود.
این مقاله به بررسی معماری پایگاه دانش و پایپلاین فنی استخراج سؤالات چالش پرسش و پاسخ متارنگ میپردازد. این معماری در نوتبوک Index Civilization Digital Metarang با هدف سازماندهی ۳۶۹ سؤال موجود و فراهمکردن بستری استاندارد برای تولید سؤالات جدید طراحی شده است.
ساختار مورد بررسی از چند بخش اصلی تشکیل میشود: لایه منابع دانشی، سازماندهی و دستهبندی اطلاعات، استخراج و اعتبارسنجی سؤالات، مدل استاندارد داده، موتور مدیریت و اولویتبندی چالشها و لایه خروجی و آرشیو.
تمرکز اصلی این معماری بر ایجاد ارتباط قابل ردیابی میان هر سؤال و مستندات مرجع آن است؛ بهگونهای که پاسخ صحیح، سطح دشواری و ساختار اطلاعاتی سؤال مستقل از حدس و برداشت شخصی، بر مبنای منابع معتبر قابل بررسی باشد.
در ادامه، اجزای معماری، مدل داده، منطق عملیاتی، سازوکار کنترل کیفیت و چرخه توسعه این زیرساخت تشریح میشوند.
کلیدواژهها: مدیریت دانش، پایگاه دانش، مهندسی نرمافزار، معماری سیستمهای اطلاعاتی، استخراج سؤال، اعتبارسنجی داده، ردیابی منبع، متارنگ.
۲. مقدمه و بیان مسئله: چرا مستندات بهتنهایی یک پایگاه دانش نیستند؟
در پروژههای نرمافزاری و اکوسیستمهای دیجیتال، دانش معمولاً در منابع متعددی توزیع میشود. بخشی از اطلاعات در مستندات معماری قرار دارد، بخشی در کدهای منبع و مخازن توسعه ثبت میشود و بخش دیگری در وایتپیپرها، مستندات اقتصادی، طراحیهای سهبعدی، قراردادها و فرآیندهای سازمانی نگهداری میشود.
این پراکندگی، دسترسی یکپارچه به اطلاعات را دشوار میکند. حتی زمانی که مستندات موجود و معتبر هستند، نبود یک ساختار استاندارد برای دستهبندی، بازیابی و ارتباطدهی آنها میتواند استفاده مجدد از دانش را محدود کند.
برای مثال، اطلاعات مربوط به معماری بکاند ممکن است در مستندات Go و Node.js، ساختار Clean Architecture، ارتباطات gRPC-Web یا تنظیمات Envoy قرار داشته باشند. در مقابل، اطلاعات مربوط به محیط سهبعدی در مستندات Unity، Prefabها، Addressables و خروجیهای WebGL یا Quest ثبت شده باشند.
اگر هدف، تولید یک سؤال تخصصی درباره هرکدام از این موضوعات باشد، صرفاً دسترسی به متن مستندات کافی نیست. باید مشخص شود:
- اطلاعات موردنیاز دقیقاً از کدام منبع استخراج میشود؟
- موضوع در چه دسته دانشی قرار میگیرد؟
- سؤال چگونه از اطلاعات مستند تولید میشود؟
- کدام پاسخ با منبع اصلی مطابقت دارد؟
- چگونه میتوان صحت پاسخ را در آینده دوباره بررسی کرد؟
- داده تولیدشده با چه ساختاری به سامانه مدیریت چالش منتقل میشود؟
بنابراین مسئله اصلی، صرفاً ذخیرهسازی مستندات نیست؛ بلکه تبدیل اطلاعات اولیه به واحدهای دانشی ساختاریافته و قابل استفاده در یک فرآیند عملیاتی است.
در معماری متارنگ، نوتبوک Index Civilization Digital Metarang برای پاسخ به همین نیاز در نظر گرفته شده است. این نوتبوک نقش مرکز سازماندهی دانش و مدیریت اطلاعات مرتبط با چالشهای پرسش و پاسخ را بر عهده دارد.
هدف اولیه، سازماندهی ۳۶۹ سؤال تدوینشده و ایجاد بستری برای تولید بانک جامع سؤالات جدید بر اساس مستندات رسمی متارنگ است.
۳. مبانی مفهومی
برای درک معماری سامانه، ابتدا باید چهار مفهوم اصلی آن را از یکدیگر تفکیک کنیم.
۳.۱. پایگاه دانش (Knowledge Base)
پایگاه دانش ساختاری سازمانیافته برای نگهداری اطلاعاتی است که قابلیت بازیابی، دستهبندی، ارزیابی و استفاده مجدد دارند.
در یک پایگاه دانش، اطلاعات صرفاً به شکل متنهای مستقل ذخیره نمیشوند؛ بلکه هر واحد اطلاعاتی باید در یک ساختار مشخص قرار گیرد و ارتباط آن با موضوع و منبع مربوط حفظ شود.
در معماری متارنگ، پایگاه دانش از مستندات رسمی حوزههای مختلف اکوسیستم تغذیه میشود. این حوزهها شامل نرمافزار، Unity، اقتصاد، بلاکچین، امنیت، الگوریتمها و فرآیندهای سازمانی هستند.
خروجی این لایه، مجموعهای از اطلاعات مرجع برای تولید و اعتبارسنجی سؤالات تخصصی است.
۳.۲. پایپلاین استخراج سؤال (Question Extraction Pipeline)
پایپلاین استخراج سؤال، مجموعه مراحلی است که اطلاعات موجود در منابع دانشی را به دادههای ساختاریافته قابل استفاده در چالش پرسش و پاسخ تبدیل میکند.
این فرآیند را میتوان از نظر منطقی به مراحل زیر تقسیم کرد:
- ۱. شناسایی و انتخاب منبع معتبر.
- ۲. استخراج اطلاعات مرتبط با موضوع موردنظر.
- ۳. تعیین دسته تخصصی سؤال.
- ۴. تدوین متن سؤال بر اساس اطلاعات استخراجشده.
- ۵. تعریف چهار گزینه متمایز.
- ۶. تعیین پاسخ صحیح و بررسی انطباق آن با منبع.
- ۷. تعیین سطح دشواری.
- ۸. ثبت ارجاع منبع و آمادهسازی داده برای ذخیرهسازی.
این مراحل، چارچوب منطقی تولید سؤال را مشخص میکنند. جزئیات الگوریتمی پیادهسازی هر مرحله، در مستندات مرجع معماری تعیین نشده است.
۳.۳. اعتبارسنجی پاسخ (Answer Validation)
اعتبارسنجی پاسخ به معنای بررسی انطباق گزینه صحیح با اطلاعات موجود در منبع معتبر است.
در این معماری، پاسخ صحیح نباید صرفاً بر اساس دانش عمومی، برداشت نویسنده یا احتمال درستبودن یک گزینه تعیین شود.
مبنای اعتبارسنجی میتواند یکی از منابع رسمی زیر باشد:
کد منبع نرمافزار؛
مستندات رسمی فنی؛
معماری مصوب؛
وایتپیپر؛
مستندات معتبر اقتصادی و امنیتی اکوسیستم.
برای نمونه، اگر سؤالی درباره ارتباطات gRPC-Web طراحی شود، پاسخ صحیح باید با مستندات فنی مرتبط با همان بخش مطابقت داشته باشد.
به همین ترتیب، سؤال درباره مدل اقتصادی PSC یا PSD باید به اطلاعات معتبر اقتصادی و مستندات مربوط به آن ارجاع داشته باشد.
۳.۴. ردیابی منبع (Source Traceability)
ردیابی منبع، امکان شناسایی منشأ اطلاعات و بررسی مجدد اعتبار آن را فراهم میکند.
در مدل داده متارنگ، فیلد source_reference برای حفظ ارتباط سؤال با منبع اصلی در نظر گرفته شده است.
این فیلد باعث میشود پاسخ صحیح صرفاً یک مقدار ذخیرهشده در بانک اطلاعاتی نباشد؛ بلکه امکان مراجعه به منشأ علمی یا فنی آن نیز وجود داشته باشد.
در مستندات تکمیلی داوران و مجمع علمی نیز منبع هر سؤال، دلیل صحت گزینه صحیح و ارجاع دقیق به سند، کامیت، تسک یا معماری مرتبط ثبت میشود.
۴. معماری سامانه: از منبع اولیه تا خروجی عملیاتی
معماری پایگاه دانش متارنگ را میتوان به پنج لایه مفهومی تقسیم کرد. این تقسیمبندی برای توضیح ارتباط اجزای سامانه ارائه میشود و به معنای وجود پنج سرویس نرمافزاری مستقل نیست.
۴.۱. لایه منابع دانشی (Knowledge Sources)
اولین بخش معماری، منابعی هستند که اطلاعات موردنیاز برای تولید سؤالات از آنها استخراج میشود.
این منابع در چند حوزه اصلی سازماندهی شدهاند.
الف) زیرساخت نرمافزاری و بکاند
مستندات مرتبط با بکاند، وب و میکروسرویسها در این بخش قرار میگیرند. موضوعات اصلی عبارتاند از:
Clean Architecture؛
ارتباطات gRPC-Web؛
Envoy؛
WebSocket؛
Revalidation Based-Tag؛
Prisma؛
PostgreSQL.
این مستندات میتوانند مبنای تولید سؤالات درباره معماری نرمافزار، ارتباط میان سرویسها و ساختار زیرساخت وب باشند.
ب) رندرینگ و معماری چندسکویی
این دسته شامل مستندات Metarang-Unity، معماری صحنهها، Prefabهای مرجع، سیستم Addressables و اجرای پروژه در محیطهای مختلف است.
پلتفرمهای مورد اشاره شامل WebGL، Quest و Windows هستند.
ج) اقتصاد و فناوریهای غیرمتمرکز
در این بخش اطلاعات مرتبط با موارد زیر قرار میگیرند:
توکنهای PSD و PSC؛
مدل انتشار پادکاهشی؛
استخرهای نقدینگی؛
قراردادهای هوشمند؛
زیرساخت Arbitrum L2.
این منابع برای استخراج سؤالات مرتبط با مدل اقتصادی و سازوکارهای فناوری غیرمتمرکز استفاده میشوند.
د) الگوریتمهای هسته متارنگ
این دسته شامل مستندات الگوریتمهای داخلی اکوسیستم است؛ از جمله:
محاسبه امتیاز در سطوح شهروندی؛
حد تأثیر؛
مکانیزمهای ضدتبانی مبتنی بر ZKP؛
سود ساعتشمار؛
مکانیک پلههای سطوح.
هـ) امنیت و فرآیندهای سازمانی
این بخش اطلاعات مربوط به امنیت و گردش کار را پوشش میدهد:
STRIDE؛
OWASP؛
الزامات افتا؛
قراردادهای پیمانکاران؛
تحویل کدهای منبع؛
اتوماسیون گردش کار با AI Agent و n8n.
علاوه بر این دستهها، برای تولید سؤالات جدید پنج حوزه محتوایی مشخص نیز در نظر گرفته شده است:
۱. چالشهای طراحی آریانا، رویدادهای تقویمی و مسابقات گذشته؛
۲. تغییرات نسخههای نرمافزاری از V1.1.21 تا V1.1.35؛
۳. معماری Go و Node.js، Clean Architecture، Ports & Adapters، Web-gRPC و Ticket Allocation؛
۴. فناوریهای سهبعدی شامل Unity، WebGL، Quest، Addressables، GLB/glTF و همگامسازی موقعیت؛
۵. وایتپیپرها، مدل اقتصادی PSC و PSD، معماری STRIDE، ZKP، الگوریتمهای رأیگیری و سازوکارهای نقدینگی.
این تقسیمبندی کمک میکند منابع متنوع، در حوزههای دانشی مشخص قرار بگیرند و تولید سؤال از مسیر موضوعی قابل تشخیص انجام شود.
۴.۲. لایه سازماندهی دانش (Knowledge Organization)
پس از شناسایی منابع، اطلاعات باید در دستههای تخصصی سازماندهی شوند.
برای مثال، یک سند درباره PostgreSQL در حوزه زیرساخت نرمافزاری قرار میگیرد، درحالیکه اطلاعات مربوط به Addressables به حوزه رندرینگ و معماری چندسکویی تعلق دارد.
در این مرحله، موضوع اصلی اهمیت دارد؛ زیرا دستهبندی صحیح به بازیابی اطلاعات و جلوگیری از اختلاط مفاهیم حوزههای مختلف کمک میکند.
در معماری مورد بررسی، این لایه زمینه لازم برای تبدیل مستندات به سؤالات موضوعی را فراهم میکند.
۴.۳. لایه استخراج و اعتبارسنجی سؤال
در این مرحله، اطلاعات استخراجشده به ساختار پرسش و پاسخ تبدیل میشوند.
هر سؤال باید شرایط زیر را داشته باشد:
موضوع مشخص و قابل تشخیص؛
پاسخ صحیح مشخص و قابل اثبات؛
چهار گزینه متمایز؛
نبود ابهام و چندپاسخی بودن؛
انطباق با مستندات رسمی؛
سطح دشواری مشخص؛
منبع دقیق برای بررسی پاسخ صحیح.
برای درک بهتر، فرض کنیم قرار است سؤالی درباره معماری نرمافزاری متارنگ تولید شود.
ابتدا مستند مرتبط با موضوع شناسایی میشود. سپس اطلاعات موردنیاز از همان منبع استخراج و موضوع سؤال مشخص میشود. پس از تدوین سؤال و گزینهها، پاسخ صحیح با مستند مرجع تطبیق داده میشود.
در نهایت، سطح دشواری و ارجاع منبع ثبت میشوند.
نکته مهم این است که چهارگزینهای بودن سؤال بهتنهایی معیار کیفیت نیست. کیفیت زمانی قابل ارزیابی است که تنها یک گزینه با منبع معتبر مطابقت داشته باشد و سایر گزینهها موجب ابهام یا برداشت چندگانه نشوند.
۴.۴. لایه موتور چالش (Challenge Engine)
پس از آمادهسازی داده، سؤال وارد ساختار عملیاتی چالش میشود.
در این بخش، سامانه علاوه بر نگهداری اطلاعات، باید قواعد ایجاد، پیکربندی، توزیع، پاسخدهی، رتبهبندی و آرشیو را مدیریت کند.
امکان ایجاد و پیکربندی چالش برای کاربران دارای سطح خبرنگار، معادل سطح دوم با ۱۰۰۰ امتیاز، و سطوح بالاتر در نظر گرفته شده است.
بنابراین کاربران سطح شهروند عادی امکان ایجاد چالش یا طرح سؤال در این ساختار را ندارند.
موتور Engine Discovery Priority نیز وظیفه اولویتبندی چالشها برای کاربران را بر عهده دارد. یکی از معیارهای اصلی این فرآیند، ارزش جایزه اختصاصیافته به هر سؤال است.
در نتیجه، ارزش جایزه بهعنوان یکی از معیارهای شناسایی و اولویتبندی چالشها مورد استفاده قرار میگیرد.
۴.۵. لایه خروجی و نگهداری اطلاعات
آخرین بخش معماری، آمادهسازی داده برای استفاده در پنل مدیریت و نگهداری سوابق عملیاتی است.
دو خروجی اصلی برای پایپلاین در نظر گرفته شده است:
فایل Excel؛
فایل JSON.
این خروجیها برای انتقال مستقیم سؤالات به سیستم مدیریت چالشها استفاده میشوند.
همچنین مستند مستقلی برای داوران و مجمع علمی تهیه میشود که منبع هر سؤال، دلیل صحت پاسخ صحیح و ارجاع دقیق به سند، کامیت، تسک یا معماری مرتبط را ثبت میکند.
۵. مدل داده: هر سؤال چگونه به یک واحد اطلاعاتی استاندارد تبدیل میشود؟
یکی از الزامات مهم در طراحی پایگاه دانش، تعریف ساختار ثابت برای دادههاست.
اگر سؤالات با قالبهای متفاوت ذخیره شوند، استفاده از آنها در ابزارهای مدیریتی، فرآیندهای پردازشی و سامانههای آینده دشوار خواهد شد.
به همین دلیل، برای هر سؤال مجموعهای از فیلدهای مشخص در نظر گرفته شده است.
۵.۱. اجزای اصلی مدل داده
هر رکورد سؤال شامل اطلاعات زیر است:
فیلد
وظیفه
شناسه یکتا
شناسایی مستقل هر سؤال
دسته تخصصی
تعیین حوزه دانشی سؤال
منبع
معرفی مستند مرجع
محدوده نسخه
مشخصکردن محدوده نسخه مرتبط
متن سؤال
محتوای اصلی پرسش
چهار گزینه
گزینههای پاسخ
پاسخ صحیح
تعیین گزینه معتبر
سطح دشواری
مشخصکردن درجه دشواری سؤال
شناسه نویسنده
شناسایی نویسنده سؤال
نوع پاداش
مشخصکردن نوع پاداش
اطلاعات تبلیغاتی
دادههای مربوط به عنوان و پیوند تبلیغاتی
source_reference
ارجاع به منشأ اطلاعات
۵.۲. ساختار شناسه سؤال
برای شناسایی سریعتر سؤالات، ساختاری مشابه نمونه زیر در نظر گرفته شده است:
Q-V1135-NET-001
این شناسه امکان تشخیص بخشهای مختلف هویت سؤال را فراهم میکند:
Q: نشانگر سؤال؛
V1135: محدوده نسخه؛
NET: شناسه حوزه تخصصی شبکه؛
001: شماره سؤال در ساختار مربوط.
وجود شناسه یکتا کمک میکند هر سؤال در فرآیند ذخیرهسازی، انتقال و مدیریت قابل شناسایی باشد.
۵.۳. اهمیت source_reference
در میان فیلدهای مدل داده، source_reference اهمیت ویژهای دارد.
بدون ارجاع به منبع، پاسخ صحیح تنها بهصورت یک مقدار در رکورد ذخیره میشود. در چنین وضعیتی، بررسی مجدد صحت پاسخ و تشخیص منشأ آن دشوار خواهد بود.
اما با ثبت ارجاع منبع، امکان ارتباط دادن سؤال به سند، کامیت، تسک یا معماری مربوط فراهم میشود.
برای مثال، اگر سؤال درباره یک قابلیت نرمافزاری باشد، ارجاع آن میتواند به مستند یا کامیت مرتبط متصل شود.
در نتیجه، هر رکورد علاوه بر محتوای پرسش و پاسخ، دارای زمینه اطلاعاتی لازم برای بررسی و ممیزی خواهد بود.
۶. منطق عملیاتی: بودجه، اولویتبندی، پاسخدهی و آرشیو
پایگاه دانش زمانی به یک زیرساخت عملیاتی تبدیل میشود که دادههای تولیدشده در چارچوب قوانین اجرایی مشخص مورد استفاده قرار گیرند.
در معماری چالش متارنگ، چهار موضوع اصلی در این بخش اهمیت دارند.
۶.۱. مدیریت بودجه و ظرفیت سؤال
تعداد سؤالات قابل ثبت در هر چالش باید با بودجه تخصیصیافته هماهنگ باشد.
برای محاسبه ظرفیت، رابطه زیر در نظر گرفته شده است:
ظرفیت سؤالات = ⌊ کل بودجه چالش ÷ جایزه هر سؤال ⌋
نماد ⌊ ⌋ نشاندهنده گرد کردن حاصل تقسیم به سمت پایین است.
برای مثال، اگر بودجه یک چالش ۱۰۰۰ واحد دارایی و جایزه هر سؤال ۱۰۰ واحد باشد، ظرفیت قابل ثبت برابر با ۱۰ سؤال خواهد بود.
این محاسبه مانع ثبت سؤالات بیشتر از ظرفیت مالی تعیینشده میشود.
داراییهایی مانند رنگ قرمز، آبی و زرد، PSC و سایر داراییهای تعریفشده نیز میتوانند در تأمین بودجه چالش مورد استفاده قرار گیرند.
بنابراین تعداد سؤالات قابل ارائه مستقیماً با منابع مالی اختصاصیافته به چالش ارتباط دارد.
۶.۲. اولویتبندی چالشها
موتور Engine Discovery Priority مسئول اولویتبندی چالشها برای کاربران است.
در این ساختار، ارزش جایزه اختصاصیافته به هر سؤال یکی از معیارهای اصلی اولویتبندی محسوب میشود.
هدف این سازوکار، فراهمکردن امکان شناسایی بهتر چالشهای دارای ارزش جایزه بالاتر در فهرست پیشنهادی کاربران است.
۶.۳. محدودیت پاسخدهی و جلوگیری از تکرار
یکی از مسائل مهم در سامانههای رقابتی، جلوگیری از پاسخدهی مجدد و نامحدود به یک سؤال است.
در ساختار متارنگ، پس از پاسخ اشتباه، شناسه سؤال برای همان کاربر در ساختار شرکتکننده قفل میشود.
به این ترتیب، امکان تکرار بینهایت یک سؤال توسط یک کاربر کاهش پیدا میکند.
این مکانیزم در کنار قوانین امتیازی، به حفظ سلامت فرآیند رقابت کمک میکند.
نکته قابل توجه این است که قفلشدن شناسه سؤال برای همان کاربر تعریف شده است و نباید آن را با حذف سؤال از کل سامانه یا محدودیت عمومی برای سایر شرکتکنندگان اشتباه گرفت.
۶.۴. آرشیو و حفظ سوابق
چالش پس از وقوع یکی از شرایط زیر وارد وضعیت Archived میشود:
پایان بودجه؛
تکمیل ظرفیت پاسخدهی؛
رسیدن به زمان انقضا.
در این مرحله، اطلاعات اصلی چالش حذف نمیشوند.
موارد زیر در آرشیو باقی میمانند:
تعداد شرکتکنندگان؛
نسبت پاسخهای صحیح و غلط؛
میزان دارایی توزیعشده.
نگهداری این اطلاعات اهمیت دارد؛ زیرا سوابق چالش را برای تحلیلهای بعدی حفظ میکند و امکان مراجعه به عملکرد گذشته را فراهم میسازد.
۷. کنترل کیفیت و چرخه توسعه
معماری داده بدون کنترل کیفیت در مراحل توسعه و استقرار نمیتواند بهتنهایی پایداری سامانه را تضمین کند.
به همین دلیل، پیادهسازی پایپلاین استخراج سؤال نیز باید مطابق چرخه استاندارد توسعه نرمافزار انجام شود.
۷.۱. مدیریت نسخه و شاخههای توسعه
تمام مراحل توسعه باید در مخزن اختصاصی پروژه و روی برنچ تعیینشده انجام شوند.
ساختار توسعه مطابق یکی از رویکردهای زیر خواهد بود:
GitFlow؛
Feature Branch.
این روش به تفکیک تغییرات، مدیریت توسعه و بررسی کد پیش از ادغام کمک میکند.
۷.۲. محیط Staging و آزمون پذیرش
پس از پایان توسعه اولیه، نسخه کاندید باید روی محیط Staging یا Development Server مستقر شود.
در این محیط، آزمونهای پذیرش و Smoke Test انجام میشوند تا عملکرد اولیه بخشهای اصلی سامانه بررسی شود.
این مرحله پیش از ورود نسخه به فرآیند ادغام نهایی اهمیت دارد.
۷.۳. مستندسازی و کنترل استاندارد کد
فایل README باید بهروز باشد و اطلاعات موردنیاز برای اجرای پروژه را در اختیار توسعهدهندگان قرار دهد.
مواردی که باید در این مستند توضیح داده شوند عبارتاند از:
مراحل اجرا؛
مراحل تست؛
متغیرهای محیطی.
همچنین کد باید از Quality Gateهای تعیینشده عبور کند.
این کنترلها شامل موارد زیر هستند:
Linting؛
تحلیل ایستا؛
رعایت استانداردهای کدنویسی.
۷.۴. کنترل امنیت و وابستگیها
امنیت در این معماری تنها به حفاظت از دادههای نهایی محدود نمیشود؛ بلکه سورسکد و وابستگیهای نرمافزاری نیز باید بررسی شوند.
آسیبپذیریهای مرتبط با کد منبع و وابستگیها باید توسط ابزارهای امنیتی شناسایی و برطرف شوند.
همچنین اتصال صحیح به Sentry برای ثبت و ردیابی خطاهای بحرانی باید برقرار باشد.
۷.۵. تست خودکار و رویکرد TDD
منطق حیاتی سامانه باید تحت تستهای خودکار قرار گیرد.
در بخشهای حساس نیز پوشش تست باید تا حد ممکن بالا باشد.
استفاده از رویکرد TDD برای توسعه منطق اصلی، امکان شناسایی زودهنگام خطاهای دادهای و منطقی را افزایش میدهد.
برای این سامانه، بخشهایی مانند محاسبه ظرفیت سؤال، اعتبارسنجی ساختار داده و محدودیت پاسخدهی از جمله منطقهایی هستند که بررسی صحت عملکرد آنها اهمیت دارد.
۷.۶. CI/CD و نظارت پس از استقرار
ادغام کد تنها پس از تأیید تیم فنی یا ناظر و موفقیت Pipelineهای CI/CD انجام میشود.
اما فرآیند کنترل کیفیت با Merge پایان نمییابد.
پس از ادغام نیز باید موارد زیر بررسی شوند:
رفتار سیستم؛
لاگها؛
خطاهای ثبتشده؛
شاخصهای مانیتورینگ.
این بررسیها برای شناسایی و اصلاح رگرسیونهای احتمالی انجام میشوند.
بنابراین چرخه توسعه از مدیریت نسخه و آزمون اولیه تا ادغام، استقرار و بررسی رفتار سیستم ادامه پیدا میکند.
۸. جمعبندی: قابلیت ردیابی و توسعهپذیری در معماری مدیریت دانش
ایجاد پایگاه دانش و پایپلاین استخراج سؤالات چالش پرسش و پاسخ متارنگ را میتوان نمونهای از تبدیل مستندات پراکنده به دادههای ساختاریافته و قابل استفاده مجدد در یک سیستم اطلاعاتی دانست.
در این معماری، نوتبوک Index Civilization Digital Metarang نقش مرکز سازماندهی دانش را بر عهده دارد و مستندات حوزههای نرمافزار، سهبعدی، اقتصاد، بلاکچین، امنیت و فرآیندهای سازمانی را به منابع تولید سؤال تبدیل میکند.
ساختار سامانه تنها به تولید متن پرسش محدود نیست. هر سؤال باید دارای شناسه مشخص، دسته تخصصی، چهار گزینه، پاسخ صحیح، سطح دشواری و ارجاع منبع باشد. این ویژگی، ارتباط میان محتوای سؤال و منشأ اطلاعات را حفظ میکند.
از سوی دیگر، اتصال پایگاه دانش به منطق عملیاتی چالش، امکان مدیریت ظرفیت مالی، اولویتبندی، محدودیت پاسخدهی و آرشیو سوابق را فراهم میسازد.
تولید خروجیهای Excel و JSON نیز مسیر انتقال داده به پنل مدیریت چالشها را مشخص میکند. در کنار آن، مستند داوران و مجمع علمی، امکان بررسی منبع و دلیل صحت پاسخها را فراهم خواهد کرد.
از منظر مهندسی نرمافزار، استفاده از GitFlow یا Feature Branch، محیط Staging، آزمونهای Smoke Test، Quality Gateها، کنترل امنیت، TDD و CI/CD چارچوب توسعه و کنترل کیفیت این زیرساخت را شکل میدهد.
در نهایت، ارزش اصلی این معماری در ایجاد یک چرخه منظم میان منبع دانشی، استخراج اطلاعات، تولید سؤال، اعتبارسنجی پاسخ، استانداردسازی داده و استفاده عملیاتی قرار دارد.
به این ترتیب، بانک فعلی ۳۶۹ سؤال میتواند نقطه شروعی برای توسعه یک ساختار مستمر مدیریت و تولید دانش باشد؛ ساختاری که در آن هر سؤال علاوه بر کارکرد رقابتی، یک واحد اطلاعاتی قابل شناسایی، قابل استناد و قابل بررسی از دانش فنی و سازمانی متارنگ محسوب میشود.